Pour analyser des ventes dans un fichier, Excel ou Google Sheets peuvent suffire. Pour croiser plusieurs bases, SQL devient utile ; pour automatiser des traitements, Python apporte davantage de souplesse. Les outils d’analyse de données se choisissent d’abord selon la question à résoudre, la nature des informations et les personnes qui exploiteront les résultats. Une combinaison cohérente vaut mieux qu’une accumulation de logiciels.
Partir de la décision à prendre, pas du logiciel
L’analyse de données consiste à transformer des informations brutes en résultats interprétables : comprendre une baisse de chiffre d’affaires, comparer des populations ou repérer les motifs d’insatisfaction. Le data analyst précise la question métier, vérifie les données, réalise les traitements et communique ses conclusions avec leurs limites.
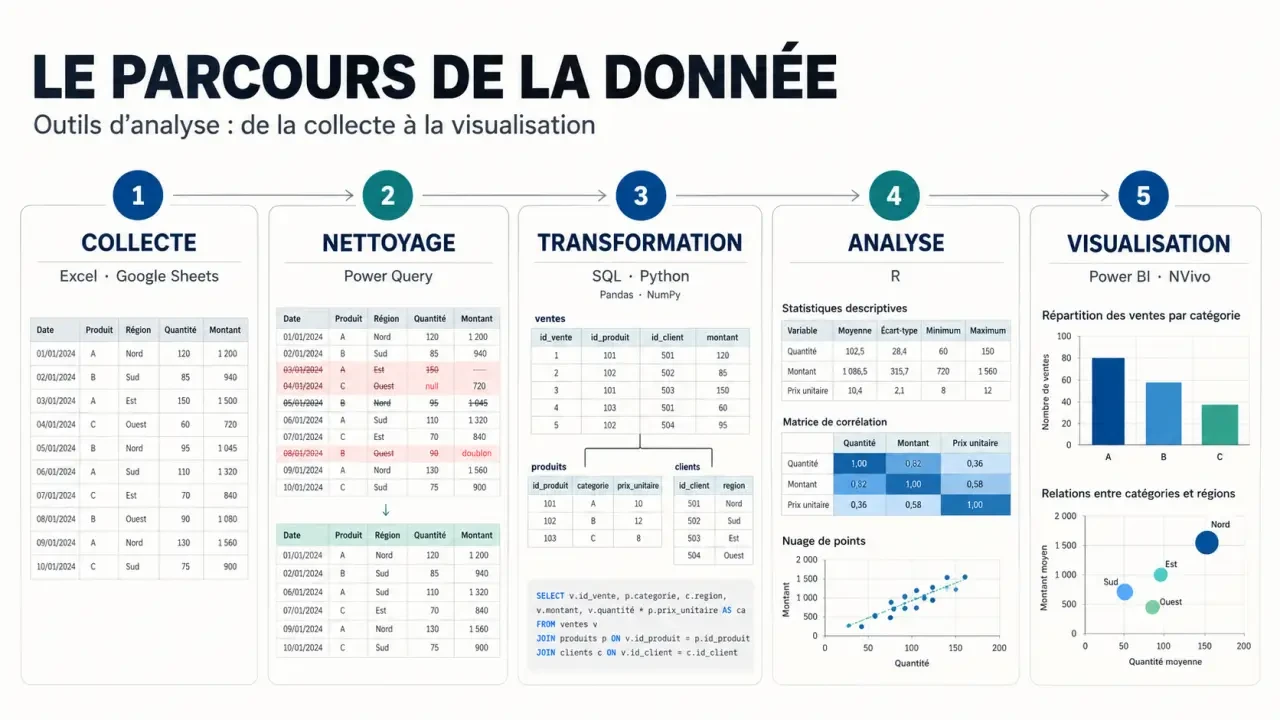
Son travail suit généralement un parcours : collecter, nettoyer, transformer, analyser, puis restituer. Un graphique ne compense ni des doublons ni une définition ambiguë du chiffre d’affaires. Avant de choisir un outil, identifiez donc les sources, la fréquence de mise à jour et le résultat attendu : analyse ponctuelle, rapport récurrent ou tableau de bord partagé.
La nature des données oriente aussi le choix. Les tableaux de ventes sont structurés ; un fichier JSON peut être semi-structuré ; les entretiens et commentaires relèvent surtout de données non structurées. Pour s’exercer, des portails comme UNdata ou des plateformes comme Kaggle donnent accès à des jeux de données. Les formats CSV, JSON, TXT et MD facilitent les échanges, mais accessibilité ne signifie pas liberté d’usage : vérifiez la licence et les éventuelles informations personnelles.
Comparer les outils selon leur vraie fonction
Un tableur, un langage et une plateforme décisionnelle ne sont pas interchangeables. SQL interroge des bases relationnelles ; Python exécute des programmes ; Pandas et NumPy sont des bibliothèques utilisées dans Python. Le tableau suivant distingue leurs usages et leurs contraintes, sans supposer qu’un produit couvre tout le parcours.
Guide officiel pour transformer vos données avec Power Query – Découvrez comment connecter Power Query à différentes sources et transformer vos données selon vos besoins.
| Outil | Usage privilégié | Niveau | Coût et disponibilité | Limite à anticiper |
|---|---|---|---|---|
| Excel / Google Sheets | Explorer des tableaux, calculer, collaborer | Débutant à intermédiaire | Excel sous licence ; Sheets accessible gratuitement avec offres professionnelles | Maintenance délicate quand fichiers et formules se multiplient |
| SQL | Filtrer, agréger et joindre des tables | Intermédiaire | Langage utilisable avec des moteurs gratuits ou commerciaux | Nécessite un accès à la base et une compréhension du modèle |
| Power Query | Importer et transformer des sources récurrentes | Débutant à intermédiaire | Disponible dans des environnements Excel et Power BI, selon les versions | Connecteurs et performances à vérifier sur les données réelles |
| Python, Pandas, NumPy | Automatiser, manipuler et calculer | Intermédiaire à avancé | Open source ; infrastructure et maintenance à prévoir | Programmation et gestion des dépendances nécessaires |
| Power BI | Construire des tableaux de bord interactifs | Intermédiaire | Création locale possible gratuitement avec Desktop ; partage selon licences | Modélisation et droits de diffusion à anticiper |
| R / SPSS / Stata | Réaliser des analyses statistiques | Intermédiaire à avancé | R est open source ; SPSS et Stata sont commerciaux | Maîtrise des méthodes statistiques indispensable |
| NVivo / Dovetail | Organiser et coder des matériaux qualitatifs | Intermédiaire | Solutions commerciales, modalités selon l’offre | Le codage exige un protocole explicite |
Le coût réel dépasse la licence. Il inclut la formation, l’hébergement, la préparation des données et le temps consacré aux incidents. Un outil open source n’élimine pas ces dépenses ; une interface visuelle n’élimine pas le besoin de méthode.
Fiabiliser les données avant d’accélérer les calculs
Du tableur aux transformations reproductibles
Excel et Google Sheets conviennent aux premières explorations : tri, filtres, formules conditionnelles, recherches et tableaux croisés. Google Sheets facilite notamment la collaboration en temps réel. Lorsque chaque nouveau fichier impose les mêmes manipulations, Power Query permet d’enregistrer une suite de transformations : modifier des types, supprimer des colonnes, fusionner des tables ou harmoniser des libellés. Data Bird mentionne plus de 300 transformations proposées par Power Query.
Une colonne mérite presque un contrat : que représente-t-elle, quelle est son unité, peut-elle être vide et quelles valeurs sont autorisées ? Un « montant » sans devise ou une « date » qui mélange commande et livraison peut fausser toute l’analyse. Consigner ces règles dans un dictionnaire de données permet de contrôler les imports et d’éviter que deux équipes calculent un même indicateur avec des définitions différentes.
SQL et Python pour croiser et automatiser
SQL sert à extraire les seules données nécessaires depuis une base relationnelle, puis à filtrer, agréger et relier les tables. Une jointure entre commandes et clients permet, par exemple, de comparer les ventes par segment. Vérifiez toutefois l’unicité des clés : une relation mal comprise peut multiplier les lignes et gonfler artificiellement les totaux.
Avec Python, Pandas facilite les fusions, les traitements de valeurs manquantes et la manipulation de séries temporelles. NumPy fournit des tableaux multidimensionnels et des opérations numériques. Cette combinaison devient pertinente pour des règles personnalisées ou des traitements répétés. Elle ne rend pas automatiquement tout volume facile à traiter : mémoire disponible, organisation des fichiers et calculs exécutés restent déterminants.
Analyser des chiffres ou comprendre des discours : deux démarches
Mesurer des écarts sans surinterpréter
Pour une analyse quantitative, commencez par les distributions, les valeurs manquantes et les anomalies. R, Python ou des logiciels comme SPSS et Stata permettent ensuite d’appliquer des méthodes telles que la régression linéaire ou l’analyse factorielle. Le choix dépend surtout du protocole et des compétences de l’équipe. Une corrélation observée ne démontre pas, à elle seule, une relation causale.
Coder les retours clients et les entretiens
L’analyse qualitative cherche à comprendre des thèmes, des expériences et des raisonnements. NVivo ou Dovetail aident à organiser les matériaux, associer des codes à des passages et comparer des groupes. Pour des entretiens, définissez une grille de codage, testez-la sur un échantillon et documentez les désaccords. Les fonctions de transcription ou d’analyse automatique varient selon les offres ; leurs résultats demandent une vérification humaine.
La restitution relie ces analyses à une décision. Matplotlib convient aux graphiques produits par script ; Power BI facilite l’exploration de tableaux de bord. Choisissez une représentation adaptée : courbe pour une évolution, barres pour des catégories. Ajoutez la période, le périmètre et les limites plutôt que de multiplier les visuels.
Retenir une combinaison adaptée et la tester en conditions réelles
Pour débuter, un tableur et une méthode de contrôle suffisent souvent. Une PME déjà équipée de Microsoft peut associer Excel, Power Query et Power BI. Une équipe technique pourra privilégier SQL pour l’extraction, Python pour les traitements et un outil de visualisation pour la diffusion. Une équipe de recherche qualitative aura plutôt besoin d’un logiciel de codage, éventuellement complété par un tableur.
Avant de généraliser une solution, faites un essai sur un cas représentatif, avec ses difficultés réelles :
- Compatibilité : tester les fichiers, API et connecteurs indispensables.
- Performance : mesurer le traitement sur un volume réaliste et vérifier la fréquence d’actualisation.
- Collaboration : distinguer les droits de lecture, de modification et d’administration.
- Confidentialité : contrôler l’hébergement et l’accès aux données sensibles.
- Reproductibilité : conserver les données brutes, documenter les règles et versionner les scripts.
- Réversibilité : vérifier les possibilités d’export avant de dépendre d’un fournisseur.
Le bon choix est celui que l’équipe sait exploiter et maintenir. Commencez par un indicateur utile, rendez son calcul fiable, puis automatisez ce qui revient régulièrement. Vous disposerez ainsi d’un système compréhensible, plutôt que d’un tableau de bord séduisant dont personne ne peut expliquer les chiffres.